01 / Cómo funciona
Tres pasos, sin instalar nada
Se trabaja desde el navegador. No hay software que instalar, ni servidor que levantar, ni plazo de puesta en marcha.
Subes el PDF
Hasta 20 páginas y 64 MB por documento. Lo arrastras a la página y listo.
El modelo lo lee
Unos 2 segundos por página, con el avance a la vista. No reconoce letras sueltas: entiende la estructura del documento.
Descargas el texto
En Word, Excel, texto plano o Markdown. Y queda guardado en tu historial.
02 / Lo que lo hace distinto
Cuatro cosas que no vas a encontrar juntas
Cualquiera convierte un PDF en un montón de texto. Lo que casi nadie hace es leer lo que ya no se ve: dos modelos leen la misma página y el contexto del documento decide, palabra por palabra, cuál de las dos lecturas es la correcta. Lo que aun así queda en duda se marca, no se rellena.
Corrige lo que quedó mal leído
Ninguna lectura es perfecta cuando el papel está viejo. Un segundo modelo repasa el texto y arregla las palabras partidas y los caracteres confundidos, sin inventar: lo ilegible queda marcado como ilegible.
Las tablas salen como tablas
En el Excel, cada tabla del documento queda en su propia hoja, con sus celdas y encabezados. No es texto pegado que hay que separar a mano.
Las fórmulas quedan editables
En el Word son ecuaciones de verdad, de las que se abren con el editor de Word. No una imagen ni un montón de símbolos sueltos.
El motor es de última generación
Detrás no hay un OCR de hace quince años, sino modelos de lenguaje visual actuales, capaces de leer un documento entendiendo lo que ven. Cuando aparece uno mejor, el motor se cambia y tú no tienes que hacer nada.
Un caso real
Esto es lo que llega
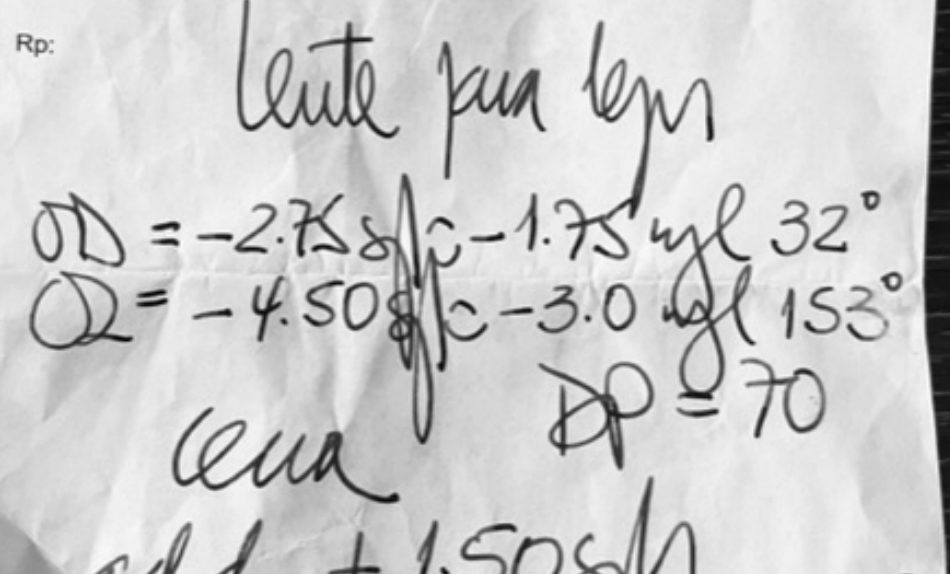
Lente para lejos
OD = −2.75 sf c −1.75 cyl 32°
OI = −4.50 sf c −3.0 cyl 153°
DP = 70
Cerca, add +1.50 sf, DP = 68
Orgánico antirreflejo
Un modelo de lenguaje actual lee esta receta. El nuestro también, y es lo mínimo que hay que exigirle hoy a cualquiera. La diferencia no está en leer una hoja suelta: está en lo que pasa después de leerla.
para tener noticias de su flaca humanidad esfumada en las sombras del misterio
para darle noticias de esa plaza humanitaria refugiada en las sombras del misterio
La segunda está en español correcto, se lee perfecta y no existe en el papel. Es justo la que nadie va a volver a revisar. Por eso acá no basta con una lectura: se cruzan dos, el contexto del documento decide palabra por palabra cuál se parece a lo que el papel puede decir, y lo que igual queda dudoso se marca para que lo mire una persona.
Hay dos motores y se elige documento por documento. Los impresos (escaneos, fotocopias, formularios, informes) los lee un motor rápido, en unos dos segundos por página. Para lo escrito a mano entra un modelo de razonamiento visual, que deduce la letra por contexto en vez de solo reconocerla: es más lento y cuesta más por página, así que no es el camino por defecto. Con manuscritos el resultado hay que revisarlo: la tecnología llegó lejos, pero todavía no reemplaza el ojo de alguien que conozca el documento.
Los archivos o documentos PDF los procesamos nosotros, en GPUs propias en Chile.
03 / Casos de uso
Quiénes pueden usarlo
Donde hay papel escaneado que alguien está transcribiendo a mano.
04 / Pruébalo
Solicita una demo
Déjanos tus datos y te habilitamos una cuenta con crédito de prueba para que lo pruebes con tus propios documentos.